Una revisión internacional rastreó estudios que usan programas computacionales para estimar riesgos oncológicos considerando la edad, los ingresos, la escolaridad o el barrio de las personas.
– De los 19 trabajos identificados, once se hicieron en Estados Unidos, y pocos comprobaron que sus herramientas funcionen igual en otras poblaciones.
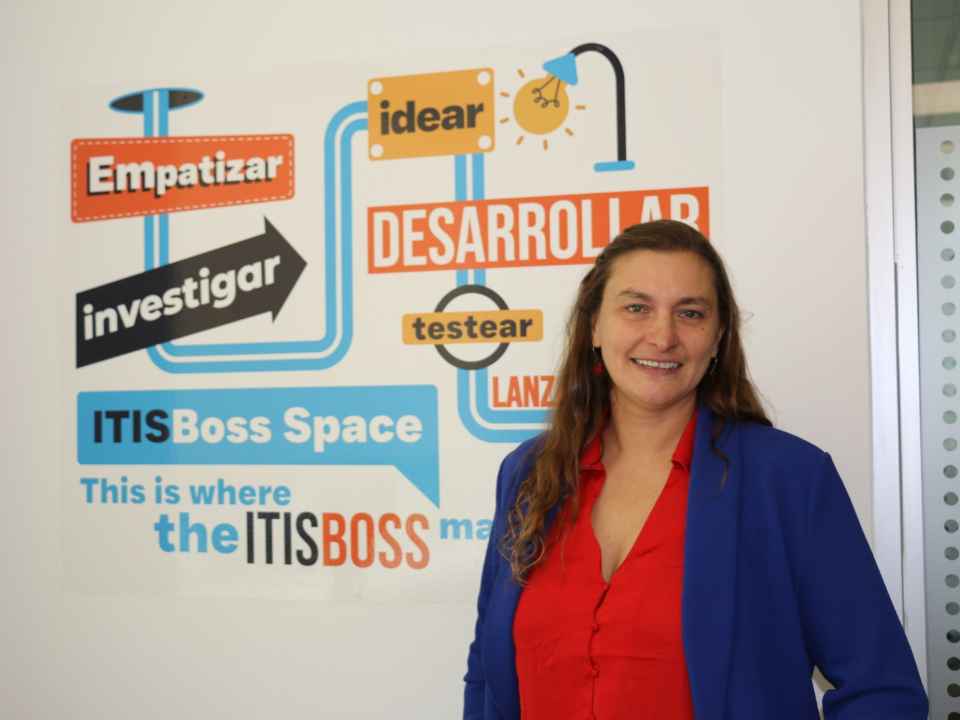
– La Dra. Carla Taramasco, directora del ITiSB de la Universidad Andrés Bello, es coautora del estudio, publicado en el Journal of Medical Internet Research contó con el apoyo de ANID a través del financiamiento FONDAP
Una revisión de 328 publicaciones científicas no encontró ningún estudio latinoamericano que use inteligencia artificial para estimar el riesgo o la evolución del cáncer a partir de las condiciones de vida de los pacientes. Los 19 trabajos que cumplieron ese criterio se realizaron en cinco países, y pocos probaron sus resultados fuera de la población donde fueron creados.
Así lo muestra una revisión publicada en el Journal of Medical Internet Research, revista científica internacional especializada en salud digital. Entre sus autores figura la Dra. Carla Taramasco, directora del Instituto de Tecnología para la Innovación en Salud y Bienestar (ITiSB) de la Universidad Andrés Bello e investigadora del Centro para la Prevención y el Control del Cáncer, CECAN.
El trabajo lo firman también Liz González-Infante, Gastón Márquez, Solange Parra-Soto y Mónica Cardona-Valencia, de la U. del Bío-Bío. El equipo revisó seis grandes bases de datos científicas hasta octubre de 2024 y aplicó un protocolo internacional que ordena paso a paso cómo buscar, filtrar y comparar estudios. La investigación contó con apoyo de ANID a través del programa FONDAP.
Los programas de IA aprenden a reconocer patrones a partir de casos anteriores, de forma parecida a como un médico gana experiencia atendiendo pacientes. En cáncer, esas herramientas ya ayudan a detectar tumores antes, estimar la sobrevida o elegir tratamientos. La mayoría aprende solo de exámenes, imágenes y datos genéticos, y deja fuera información como los ingresos, la escolaridad o la distancia al hospital, que también influye en cuándo una persona llega al diagnóstico.
“Un algoritmo puede analizar con precisión una mamografía, pero no sabe si esa mujer vive lejos de un hospital, qué previsión tiene o si tuvo que elegir entre ir a su control y no perder un día de trabajo. Todo eso también forma parte de su historia”, explica la Dra. Taramasco.
Esto apoya la labor del médico, que aporta en decisiones concretas en cuatro pilares: integra el contexto: síntomas, antecedentes familiares, cirugías previas y cambios respecto de mamografías anteriores; resuelve discrepancias: si la imagen parece normal pero existe un bulto sospechoso, decide continuar el estudio. Una mamografía normal no descarta todos los cánceres; define qué hacer: solicitar imágenes adicionales, ecografía, seguimiento o biopsia, según los hallazgos y el riesgo de la paciente. Y explica y acompaña: comunica la incertidumbre, conversa sobre las alternativas y coordina que el estudio y el tratamiento se completen.
Un mapa sin América Latina
Los 19 estudios se publicaron entre 2018 y 2024. Once provienen de Estados Unidos, cuatro de Irán, dos de India, uno de Corea del Sur y el último es una colaboración entre China y Estados Unidos. La revisión no encontró ningún trabajo realizado en América Latina, pese a que consideró publicaciones tanto en inglés como en español.
El origen de los datos importa porque cada programa aprende las reglas del lugar donde se entrena. Un modelo construido con pacientes estadounidenses incorpora cómo funciona allá el acceso a la atención, donde el tipo de seguro aparece como factor central en varios de los estudios revisados.
Al llevarlo a otro país, esas reglas pueden dejar de calzar, igual que un conductor que aprendió a manejar en una sola ciudad necesita adaptarse a calles desconocidas. “Que no haya un solo estudio latinoamericano es una señal que debemos atender. Si queremos herramientas que sirvan en Chile, tenemos que entrenarlas con datos de nuestros pacientes, porque aquí la distancia, la previsión o el nivel educacional pueden pesar de otra manera”, sostiene la investigadora.
Para los autores, la cifra de 19 trabajos refleja un campo que recién comienza. Una revisión temprana, plantean, permite ordenar lo avanzado, mostrar los vacíos y orientar la investigación que viene. La técnica más usada fue Random Forest, que combina muchos árboles de decisión –secuencias de preguntas de sí o no, como si la persona supera cierta edad o vive en zona rural– y promedia sus respuestas. Apareció en 13 de los 19 estudios.
El equipo valora ese tipo de herramientas porque permiten revisar qué datos pesaron en cada resultado. Otras técnicas, como las redes neuronales, logran predicciones más complejas, pero operan como una caja negra cuyo razonamiento resulta difícil de auditar, lo que limita su uso en la consulta médica. “Un médico no va a cambiar una decisión por un número que no puede explicar. Para que una predicción sirva en la práctica, el equipo clínico tiene que poder ver qué variables la están empujando y si eso tiene sentido para el paciente que tiene al frente”, apunta la directora del ITiSB.
Barreras antes del diagnóstico
Las condiciones de vida más analizadas fueron la edad, el sexo, el nivel educacional, los ingresos, el origen étnico y el lugar de residencia. El cáncer de mama fue el más estudiado, seguido por el colorrectal, el de pulmón y el gástrico. En mama, los modelos priorizaron la edad, el origen étnico y el nivel socioeconómico para anticipar complicaciones y diagnósticos tardíos.
En cáncer colorrectal, los ingresos, la cobertura de salud y la ubicación geográfica resultaron centrales para predecir si la enfermedad se detecta en etapa avanzada. Otros trabajos sumaron la disponibilidad de transporte y el tipo de seguro, factores que funcionan como obstáculos concretos entre una persona y su control médico.
“Cuando un modelo incorpora el ingreso, el tipo de seguro o la posibilidad de trasladarse, empieza a mostrar las barreras que separan a una persona de un diagnóstico a tiempo. Esa es información que el sistema de salud puede usar para llegar antes”, señala la Dra. Taramasco.
Un grupo reducido de estudios amplió la mirada hacia el barrio. Uno analizó si las tasas de criminalidad y el valor de las viviendas de una zona se asociaban con diagnósticos tardíos de cáncer colorrectal. Otro comparó el acceso a servicios médicos entre zonas urbanas y rurales y su relación con el retraso en la detección del cáncer de mama.
Ese tipo de información sigue siendo excepcional en la literatura. Según la revisión, sumar datos del entorno, como las condiciones de vivienda o el nivel socioeconómico de cada sector, podría mejorar los modelos y mostrar con más claridad dónde se concentran las desigualdades. Los autores aclaran que estas asociaciones sirven para anticipar riesgos y no prueban que un factor cause la enfermedad.
Una prueba que casi nadie hizo
Para comprobar que sus modelos funcionan, la mayoría de los estudios usó una técnica llamada validación cruzada. Consiste en dividir los datos, por lo general en diez partes, entrenar el programa con nueve y examinarlo con la restante, como un estudiante que se prepara con nueve guías y rinde la prueba con la décima. Así se evita que el sistema simplemente memorice los casos que ya conoce.
Ese examen, sin embargo, ocurre dentro del mismo conjunto de pacientes. La validación externa, que prueba el programa con personas de otro hospital, región o país, fue poco frecuente entre los 19 estudios. Sin ese paso, no hay certeza de que una herramienta que funciona en un lugar entregue resultados igual de confiables en otro.
La revisión identifica además un riesgo para la equidad. Cuando los programas omiten las condiciones sociales o las registran de forma desordenada, terminan reproduciendo las desigualdades de acceso a la salud en lugar de ayudar a detectarlas. “Si los datos con que se entrena un algoritmo ya traen la desigualdad incorporada y nadie la mide, el modelo la va a reproducir. Puede verse muy preciso en promedio y fallar justamente con las personas que más necesitan ser detectadas a tiempo”, advierte la investigadora de la UNAB.
Para corregirlo, los autores proponen que todos los estudios registren un mínimo común de datos (edad, sexo, origen étnico, educación, ingresos, ruralidad y previsión de salud) que permita compararlos entre sí. También piden medir si los modelos aciertan por igual en distintos grupos de la población, probarlos en varios centros de salud y publicar su código para que otros equipos puedan revisarlo. “La IA puede ayudarnos a encontrar antes a quienes hoy llegan tarde al diagnóstico. Para eso necesitamos datos sociales completos, modelos que se puedan explicar y pruebas en contextos reales, también en América Latina”, concluye la Dra. Taramasco (Por Luis Francisco Sandoval, Agencia S&M Comunicaciones).
Síguenos en redes sociales
Encuéntranos en Google
Equipo Prensa
Portal Red Salud